
2026知到答案 大模型引领的人工智能通识理论与实践(国际化)(浙江师范大学) 最新智慧树满分章节测试答案
第一章 单元测试
1、多选题:
下列关于大模型发展历史的描述中,哪些是正确的?
选项:
A:早期人工智能模型主要依赖规则系统和小规模机器学习模型,处理能力有限
B:深度学习模型如CNN和RNN的出现标志着大模型技术的成熟
C:GPT-3拥有1750亿个参数,是目前规模最大的预训练语言模型之一
D:Transformer架构的提出解决了序列数据中的长距离依赖问题
E:BERT模型采用双向预训练方式,在多项自然语言处理任务中取得最优成绩
答案: 【早期人工智能模型主要依赖规则系统和小规模机器学习模型,处理能力有限;
GPT-3拥有1750亿个参数,是目前规模最大的预训练语言模型之一;
Transformer架构的提出解决了序列数据中的长距离依赖问题;
BERT模型采用双向预训练方式,在多项自然语言处理任务中取得最优成绩】
2、单选题:
关于大模型发展历程,以下哪项描述是正确的?
选项:
A:BERT模型采用自回归语言模型方式进行预训练
B:GPT-3通过1750亿参数实现了文本生成等任务的突破
C:早期人工智能主要依赖大规模深度学习模型处理复杂任务
D:Transformer架构首次引入卷积神经网络提升图像识别能力
答案: 【GPT-3通过1750亿参数实现了文本生成等任务的突破】
3、判断题:
Transformer架构的提出是大模型发展的一个重要里程碑,它采用了自注意力机制来处理序列数据。
选项:
A:错
B:对
答案: 【对】
4、判断题:
在自注意力机制中,查询向量(Query)、键向量(Key)和值向量(Value)是通过对输入序列中的每个元素进行线性变换得到的。
选项:
A:错
B:对
答案: 【对】
5、单选题:
国内大模型生态系统中,以下哪项角色主要负责构建和训练大模型?
选项:
A:模型研发者
B:数据提供者
C:应用开发者
D:终端用户
答案: 【模型研发者】
6、判断题:
国内大模型生态系统中的模型研发者负责构建和训练大模型,需要具备深厚的数学和计算机科学知识。
选项:
A:错
B:对
答案: 【对】
第二章 单元测试
1、单选题:
下列关于大模型的定义中,哪一项是正确的?
选项:
A:大模型特指用于图像处理的卷积神经网络模型
B:大模型仅适用于自然语言处理中的机器翻译任务
C:大模型是指具有大量参数的神经网络模型,通过大规模数据集训练获得
D:大模型是指参数规模较小但性能优异的神经网络模型
答案: 【大模型是指具有大量参数的神经网络模型,通过大规模数据集训练获得】
2、判断题:
大模型通常指具有大量参数的神经网络模型,通过在大规模数据集上进行训练来学习丰富的语言模式和语义信息。
选项:
A:错
B:对
答案: 【对】
3、判断题:
大语言模型在回答历史或科学问题时,总是能提供完全准确的答案。
选项:
A:错
B:对
答案: 【错】
4、多选题:
关于Transformer架构中的注意力机制,以下哪些说法是正确的?
选项:
A:多头注意力机制是将输入序列投影到多个子空间中并行计算注意力
B:Transformer架构仅包含编码器部分,无需解码器
C:注意力机制通过计算输入序列中各个元素之间的相关性来分配权重
D:注意力机制无法处理长距离依赖关系
E:
注意力机制的核心公式为 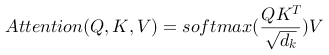
答案: 【多头注意力机制是将输入序列投影到多个子空间中并行计算注意力;
注意力机制通过计算输入序列中各个元素之间的相关性来分配权重;
注意力机制的核心公式为
】
5、单选题:
在Transformer架构中,注意力机制的核心计算步骤不包括以下哪一项?
选项:
A:计算查询矩阵与键矩阵的乘积
B:对结果应用softmax函数得到权重
C:将乘积结果除以键向量的维度的平方根
D:将权重与原始输入数据直接相加
答案: 【将权重与原始输入数据直接相加】
6、判断题:
Transformer架构由编码器和解码器组成,其中编码器负责将输入序列转化为隐藏表示,解码器则根据隐藏表示生成输出序列。
选项:
A:错
B:对
答案: 【对】
本门课程剩余章节答案为付费内容
支付后可长期查看
有疑问请添加客服QQ:2025479448反馈
购买期末请+QQ:2025479448
如遇卡顿看不了请换个浏览器即可打开
请看清楚了再购买哦,电子资源购买后不支持退款哦